
第4回 生成AI編 ~Part1~
日本のクラウド屋さんが日本企業のために作ったAIサービス「InfiniCloud AI」
この連載の前回までは、InfiniCloudのサーバーやマイクロサービス、特徴的なハードウェア構成、運用ノウハウなどを伺ってきたが、今回からは「AIとGPU」をテーマとしたい。
さて、生成系AIが日常的なツールとして浸透する昨今、企業が本格的にAIを業務に組み込もうとして検討を進めると、まず、最初に直面する大きな選択肢がある。
それは、AIシステムを、クラウド企業が提供するAIサービスを利用するか、あるいは自前で構築して運用するか…の選択だ。
機微な社内データをパブリックなAIに入力すれば、情報漏洩やプロファイリングのリスクが伴う。そのため、自社専用のローカルな環境でAIを動かす「オンプレミス回帰」のニーズが高まりつつある。しかし、ここで物理的な「電力の壁」が立ちはだかることを知る企業は少ない。
今回は、サーバーインフラのプロフェッショナルであるInfiniCloudに、日本のデータセンター事情と、現実的なAIサーバー構築の最前線について話を伺った。
日本の既存データセンターの電力事情に配慮して設計された「InfiniCloud AI」
一般ユーザーにとって生成AIはかなり身近になった。チャット欄に文字を入力し、検索エンジンの代わりに使ったり、さまざまなコンテンツを作らせたりしている。しかし、サーバー側で何が動いているのか、どんなハードウェア構成なのかを、イメージしながら使っている人は少ない。
日本国内の一般企業が現実的な規模でAIを導入する場合、どんなサービスを利用することになるのだろうか。
そうしたサービスの提供を開始しているInfiniCloudでは、企業向け生成AI基盤として「InfiniCloud AI」というサービスの提供を開始している。これは、単体のチャットボットや、一つの大規模言語モデル(LLM)を貸し出すだけのサービスというより、実体としては、複数のAIモデル(LLMを含む)や検索、検証、業務処理をまとめて動かす複合AIシステムとなっている。
このInfiniCloud AIの開発に際して、InfiniCloudの代表取締役CEOの瀧 康史氏は次のように語っている。
開発開始にあたり、意識したポイントは二つあります。
以上の2点を踏まえた上で、そうしたAIサービスを、海外の大規模AIサービスに依存するとどうでしょうか。もし、何かトラブルが起きた時、日本に拠点を置く企業としては、迅速に対処して貰えるのかについて不安が残ります。そこで、そもそもトラブルが起きにくい、あるいはトラブルが起きても対応がしやすい、日本のデータセンター事情に合う、日本企業向けのAIシステムを作れないかと、我々は考えたのです。
(代表取締役CEO:瀧 氏)
現状、日本の既存データセンターは、基本的に100V電源を中心に設計されている。AI専用データセンターを新設すれば、大電力のサーバーを自由に置くことはできるだろう。しかし、それは、場所と大電力の確保の視点で、容易なことではないのだ。 であれば、日本各地の既存データセンターにAIサーバーを導入していくのが現実解となる。しかし、それには、100V電源で稼動できる消費電力に抑えなければならない。現在の日本国内における、標準的な電源仕様は1電源回路あたり100V、15Aとなっている。この仕様は家庭用電源と変わらない。つまり、1回線あたりの最大消費電力は1500W(=100V×15A)となるのだ。
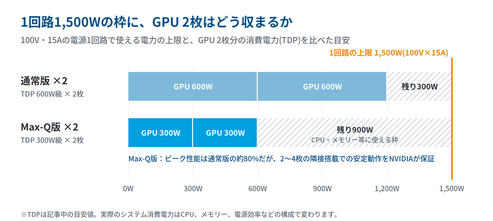
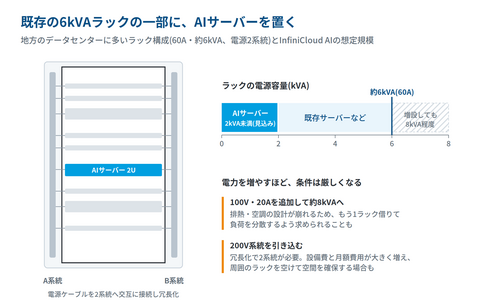
地方のデータセンターでは、1ラックあたり60A、約6kVA程度という構成が多く、増設しても8kVA程度というケースがあります。1つのラックをAIサーバーだけで占有するわけにもいきません。そのため、日本中の既存データセンターに配置できる規模で、どこまで性能を出せるかに挑戦しました。
誤解のないように言うと、1500Wは我々が扱える上限ではなく、むしろ「一番展開しやすい下限」だと考えています。1500W未満に収められれば、そこからGPUを増やしてスケールアウトしたり、より大きなモデルを載せたりするのは技術的にはずっと簡単です。逆に、日本の津々浦々にある既存データセンターへ、独立したAIを一つずつ用意していくには、1500W未満に収まる構成のほうが圧倒的に展開しやすい。だからこそ、あえて一番厳しい条件から設計を始めたのです。
(代表取締役CEO:瀧 氏)
当初は、消費電力の低い「NVIDIA L4 Tensor コア GPU」(Ada Lovelace世代、VRAM 24GB)での構築を試みたそうだが、AIを快適に動作させるにはグラフィックスメモリ(VRAM)容量が不足しており、この構成では限界があるという結論に至ったそうだ。 結果、InfiniCloud AIでは、1500W級の電力枠を意識しながら、NVIDIAの「RTX PRO 6000 Blackwell Max-Q」(Blackwell世代、VRAM 96GB)を2基搭載するワークステーション、あるいは2Uサーバー構成によって、一般企業の複数利用者で共有できるAI環境を実現したとしている。これにより、AI専用データセンターを新設せず、既存の6kVA級ラックの一部へ導入できる現実的なラインを確立したというわけだ。
クラウド専用ではなく、オンプレミス導入もできる InfiniCloud AI
AIリテラシーの高い企業は、情報漏洩リスクに配慮してAIシステムを自社内に置こうとする動きも強まっている。冒頭で述べたAI導入の際の最初の重大な2択に対して、実際、様々な議論が交わされている。
InfiniCloud AIは、クラウド型とオンプレミス型のどちらを対象にしているのだろうか。なお、オンプレミス(On-Premises)とは、サーバーやソフトウェアなどのシステムを自社で保有し、社内や自社管理の施設(構内)に設置して運用する形態のことをいう。
サーバーさえ要件(詳細は後述)を満たしていれば、基本的にはインストーラーで導入できます。
(代表取締役CEO:瀧 氏)
なお、ここで筆者から補足しておくが、InfiniCloud AIは、顧客ごとにすべてをゼロから開発する、完全なオーダーメイドのSystem Integration(以下、SI)案件ではない。完全なSI案件にすると、一件あたり数千万円規模になりやすく、想定される顧客も限定されてしまう。
とはいえ、InfiniCloud AIの導入にあたって、GPUサーバーやGPUワークステーションをどのように組み合わせるかについては、代理店が顧客に合わせてパッケージ化する形を想定しているという。
また、2026年現在、GPU高騰、ストレージデバイスやメモリーモジュールの世界的な不足状況によって、サーバー機器の入手性が悪化している。InfiniCloud側のビジネスモデルを持続・継続させる意味合いでも、顧客自身が用意した多様なハードウェアにAIシステムを導入できる設計を心がけたようだ。
(代表取締役CEO:瀧 氏)
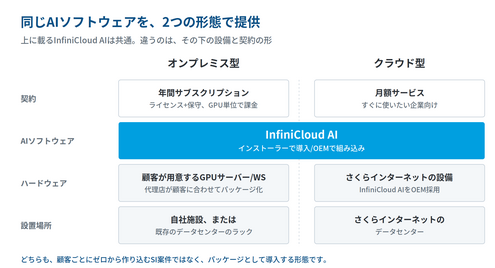
クラウド版の物理サーバーとデータセンターは、さくらインターネット側の設備を利用する形態となる。InfiniCloudは、その上で動くソフトウェアシステムとして「InfiniCloudAI」をOEM提供しているのだ。
まとめると、提供形態は、次の二つあるということになる。
- 顧客が用意したサーバーやワークステーションに導入するオンプレミス型
- さくらインターネットの設備上で利用するクラウド型
予算と設備に合わせて選べるハードウェア構成
InfiniCloud AIは、おもにNVIDIA製のGPUでの動作を想定している。AMD Instinctなどへのサポート拡大については今のところ未定だとされる。
現状では、Hopper世代のH100、H200、Blackwell世代のB100、B200、RTX PRO 6000 Blackwellなどを、複数基のGPU構成で動かせるように設計されているという。もちろん、GPUが1基構成でも利用できる。
生成系AIにおいて、大きなモデルを動かすには、VRAM容量だけでなく、動かすモデルのデータサイズに見合ったメモリー帯域が必要となる。メモリー帯域とは、簡単に言えば、メモリーのアクセス速度のことで、主に、GB/s(ギガバイト毎秒)で表される。メモリーは容量だけを増やしても、帯域が低いと、1秒あたりに生成できるトークン数が伸び悩むことも多い。
お客さまに現実的な候補として提案しやすいのは、RTX PRO 6000Blackwellですね。RTX PRO 6000 Blackwellは、民生向けのGeForce系に近いメモリー構成で、GDDR7(1792GB/s)を採用しています。HBM搭載のGPUほどの帯域はありませんが、96GBの大容量VRAMを持ちますし、価格、消費電力、調達性のバランスが取りやすい製品です。
一方で、H100/H200(Hopper世代)は、B100/B200(Blackwell世代)の先代にあたりますが、超高帯域なHBM3/HBM3e系メモリーを採用しているので、3000GB/s〜4800GB/s級もの帯域があります。GPU世代としては先代モデルですが、HBMの効果は大きいので、こちらも悪くないと思っています。
(代表取締役CEO:瀧 氏)
InfiniCloudでは、AppleSilicon(Mシリーズプロセッサ)搭載のMacも、開発環境で試しているそうだが、上位モデルはメモリー帯域も比較的高いため、大きなモデルを動かすことは出来るそうだ。しかし、使用しているライブラリやデータ形式の制約によって、BF16(AI用途に特化した、ダイナミックレンジ重視型の16ビット浮動小数点)を使えず、FP32(32ビット浮動小数点)を使わなければならないケースでは、必要帯域が増え、速度が大きく低下するという。個人用途ではよいかもしれないが、業務用途では推奨しづらい…ということで、InfiniCloud AIとしてはサポート対象になっていない。
GDDR7を採用したRTX PRO6000 Blackwellは、HBM3/HBM3e系を採用したH100/200、B100/200などと比べれば、安価なはずだが、実際のところどうなのだろうか。
私が開発に使っているのは、HP製の通常のワークステーションにRTX PRO 6000 Blackwell Max-Qを2枚搭載した構成です。CPUはワークステーション向けのIntel Xeon系で、メインメモリは256GBです。本当は512GB欲しかったのですが、現在の容量でも実用的に動いています。
実際のLLM処理では、GPU演算器の使用率が常に100%へ張り付くわけではなく、メモリー帯域側が先に上限に達する場面が多くあります。そのため、消費電力を抑えたMax-Qを2枚使ってVRAM容量を2倍に増やす構成は、企業向けとしてバランスがよいと考えています。この構成でも、社内の一定人数が共有してAIを利用できる規模にできます。
(代表取締役CEO:瀧 氏)
ここで補足説明をしておこう。
近代AIシステムを動作させる場合に、GPUが必要になるわけだが、大別してGPUにはコンシューマ版、ワークステーション/サーバー版、データセンター版の3種類がある。コンシューマ版はGeForceブランドの製品で主にゲーム用途やデジタル創作用途で使われる。ワークステーション/サーバー版はRTX PROブランドで、より規模の大きいデータセンター版は、NVIDIA DGXシリーズになる。
それと、ここまでで何度か、発言にも登場している「Max-Q版」についても補足したい。
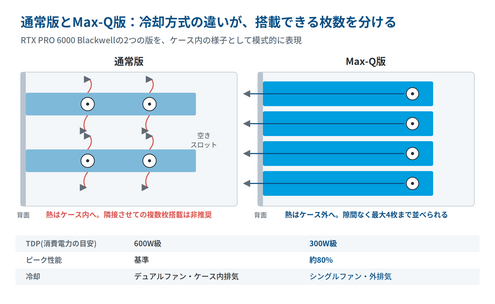
Max-Qとは、元々は、NVIDIAが、熱要件と電力要件に配慮した動作モードに最適化されたノートPC向けGPUに付けられていたブランド名だった。しかし、近年では、このMax-Qの称号がワークステーション/サーバー版GPUにも用いられるようになっている。通常版はTDP(≒消費電力)が600W級なのに対し、Max-Q版は300W級に設定されている。Max-Q版のピークGPUコア自体の性能は、通常版の80%程度に抑えられているが、一方で、GPUカードの2〜4枚挿しの高密度構成での安定動作をNVIDIAが保証しているメリットがある。
通常版もMax-Q版も、カード自体の占有スロット数(カード自体の厚み)は2スロットで同じだが、通常版はデュアルファンでケース内排気なのに対し、Max-Q版はシングルファンで外排気となっている。この特性の違いで、Max-Q版は空きスロット無しで、隣接させたスロットに最大4枚のMax-Q版カードを挿すことが出来る。通常版はピーク性能が高いが、空きスロットなしの複数枚カードの隣接搭載が非推奨とされている。
なお、同じRTX PRO 6000 Blackwellでも、ワークステーションに載せるのは空冷ファンを備えたMax-Q版、ラックマウントのサーバーに載せるのは前後エアフローに合わせたServerEdition版、と筐体によって選ぶ版が変わる。さらに上の性能が必要なら、データセンター向けのB200などが選択肢となる。
(代表取締役CEO:瀧 氏)
自社施設内、あるいは既存のデータセンターで利用出来るInfiniCloudAI
上でも述べているが、日本のような100V電源環境では、一般に1回路あたり1500W程度が一つの目安になる。GPUを複数搭載して1500Wを超える場合、データセンターではどのように対応するのだろうか。
200Vを使う場合も、冗長化を考えれば二系統必要です。200V・30Aの系統を複数引くような構成になると、設備コストと月額費用が大きく増えます。一般的なラック自体は、場所にもよりますが月額10万〜15万円程度で借りられるケースがあります。しかし、電力を追加すると、ラック代より電気関連費用の方が高くなることがあります。
データセンター側にとっては、電力だけでなく排熱も問題です。一か所のラックに高密度で電力を使われると、空調と排熱の設計が崩れます。そのため、100V・20Aを追加するよりも、もう一つラックを借りて負荷を分散してほしいと求められることがあります。
(代表取締役CEO:瀧 氏)
ここについても、筆者が補足しておこう。 データセンター側にとっては、電力だけでなく排熱も問題になる。たとえば、60A(約6kVA)のラックにさらに100V・20Aを追加し、約8kVAまで高密度化するよりも、もう1ラックを借りて負荷を分散してほしいと求められることもある…ということだ。 大電力の200V系統を要求した場合、周囲のラックを空け、その機械のためだけに空間を確保するケースもある。その場合の月額利用コストはさらに増すことになる。 以上の理由から、一般的な日本国内データセンターに「GPU専用の高密度ラックを置きたい」と相談しても、難しいと言われることが多いのが実情のようだ。瀧氏によれば、海外の展示会で見るような、サーバー、電源、冷却設備を一体で設計したAI向け設備は、日本の既存データセンターで採用されるケースはまだまだ限定的なのだそうだ。
こうした既存設備の多くは、もともとGPUサーバーを高密度で置くために作られたわけではありません。電力会社系が新設すれば大規模な設備を作れる場合もありますが、GPUに特化したデータセンターはまだ多くありません。
工場や地域拠点の近くにあるデータセンターを使いたい企業もあります。データを遠隔地の巨大クラウドに集中させるのではなく、地元の近い設備を使いたいという需要です。しかし、その場所でAIを動かそうとすると、電力が足りない問題が起きます。そのような企業でも利用できるAIシステムが必要だと考えたことが、InfiniCloud AIの設計につながっています。
(代表取締役CEO:瀧 氏)
2025年、日本の経済産業省及び総務省は、電力インフラ(ワット)と情報通信インフラ(ビット)を一体的に最適化し、再生可能エネルギーの供給地周辺へAI用データセンターの分散配置などを進める国家戦略的な構想「ワット・ビット連携」を政策として推進している。実質的に、電力設備とデータセンターを近接させるこの構想は効率面で有利だが、一方で、インフラを集中させることによる安全保障上のリスクなどもあり、効率、レイテンシー、セキュリティ、国防をどう両立するかは難しい問題となっている。
いずれにせよ、この構想が、実用的な形で実を結ぶのは2030年代に突入してからとなる。
InfiniCloudのInfiniCloudAIは、この構想の実現前に、現状の日本で、現実的な形で、AIサービスの導入を進めるのに適した運用形態とするべく、開発されたということなのだろうか。
巨大なAIデータセンターを作れる企業は限られる。一般企業にとって、InfiniCloud AIはどの程度の規模から導入できるのかを聞いてみた。
サーバー版のGPUを2枚搭載する場合でも、2Uサーバー程度に収まる構成を想定しています。実効消費電力は2kVA未満に抑えられる可能性があり、6kVAのラックの一部を使う形で置けると考えています。つまり、「自社がすでに借りているラックの一部にAIサーバーを置きたい」という需要にも対応できます。より高い性能が必要ならGPUを増やすこともできますが、まずは一般的な設備に置けるラインを重視しています。
(代表取締役CEO:瀧 氏)
オンプレミス版のInfiniCloud AIは買い切りなのだろうか。それとも年間契約なのだろうか。
パッケージ内にはPythonで書かれたプログラムが含まれ、ライセンス上はApache License 2.0の部分もあるため、技術的には契約終了後も自己責任で動かし続けられる部分があります。ただし、契約を終了すると、保守や更新などのサポートを受けられなくなります。
また、課金単位はGPUです。一般的なエンタープライズソフトウェアではCPUソケット単位のライセンスが多くありますが、そのGPU版と考えると分かりやすいでしょう。
GPUが2基なら2ライセンス、4基なら4ライセンスという考え方です。
(代表取締役CEO:瀧 氏)
第1回はここまで。
第2回となる次回は、InfiniCloudAI Version 2の構成図を基に、エージェンティックAI、複数モデルのオーケストレーション、Version 1からVersion 2への進化、知能ドメイン、⊿W、RAGと長期学習などを扱う予定だ。